
正直に白状します。WordPressの保守管理サポートを提供している弊社の自社サイトの表示速度が遅くなりました。今回の障害対応から原因判明、解決までの一部始終が、同じ問題を抱えているWordPressサイトにそのまま役立つ内容かと思い、発生から解消まで公開することにしました。
結論から先に書くと、原因は永続オブジェクトキャッシュの未導入でした。共有サーバーでWordPressを運用している方なら、同じ構造を抱えている可能性もあるはずです。
弊社監視システムからのSlack通知で発覚
弊社のWordPress保守の一環として、自社と顧客のWordPressを外部から監視するシステムをCloudflare Workers上に構築・運用しています。応答時間・HTTPステータス・ページ内容の異常を定期チェックし、異常があればSlackに通知する仕組みです。
1時間に20件弱の遅延通知
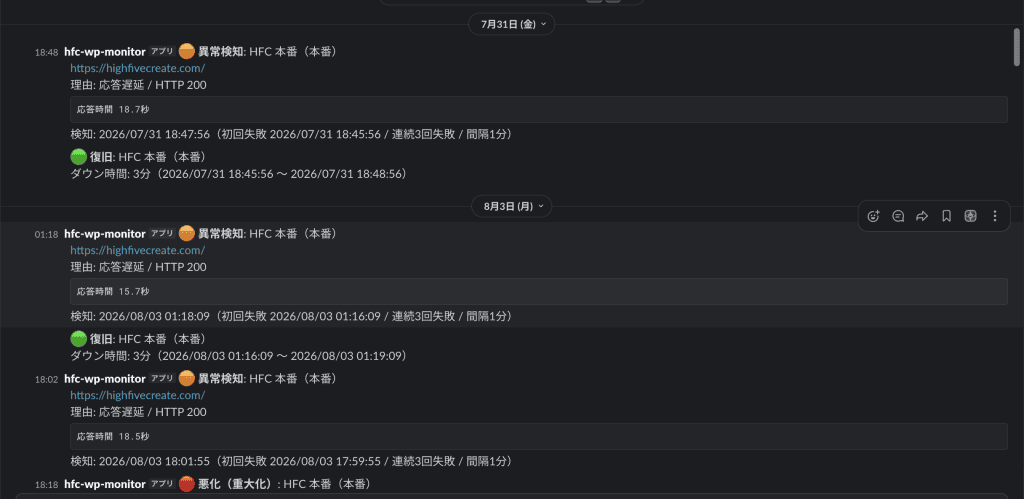
最初の通知は7月31日の夜に応答時間18.7秒の通知。このときは3分で自動復旧し完了。それが8月に入ると連続し始め、8月3日には「悪化(重大化)」の通知に変わりました。監視ログを集計すると、ピーク帯(12〜18時)には毎時9〜20件の遅延が記録されていました。数日前まではゼロだったのに突然の連続通知です。
正直に言うと、この監視システムがなければ発覚はもっと遅れていたと思います。自分でサイトを開いたときに「ちょっと遅いかな?」と感じても、たまたまだろうと流してしまうのが一般的な感覚でしょうから。
mixhostの共有サーバーが原因ではなかった
弊社コーポレートサイト(このサイトです)のホスティングは2018年にさくらインターネットから移転して以来使い続けているmixhostの共有サーバーで、手前にCloudflareを挟んでいます。
参考: フレームワークを使ってWordPressサイトをリニューアルしたら表示速度が速くなった話
先に書いておくと、今回の原因はmixhostではありませんでした。mixhostに限らず共有ホスティング共通の仕組みとして、アカウントごとにCPU割当の上限があり、その上限に達する使い方をしていたのは弊社のWordPressでした。調査の過程では、cPanelに備わっている「Resource Usage」に何度も助けられました。
調査1: 簡単に見つかる原因らしきもの
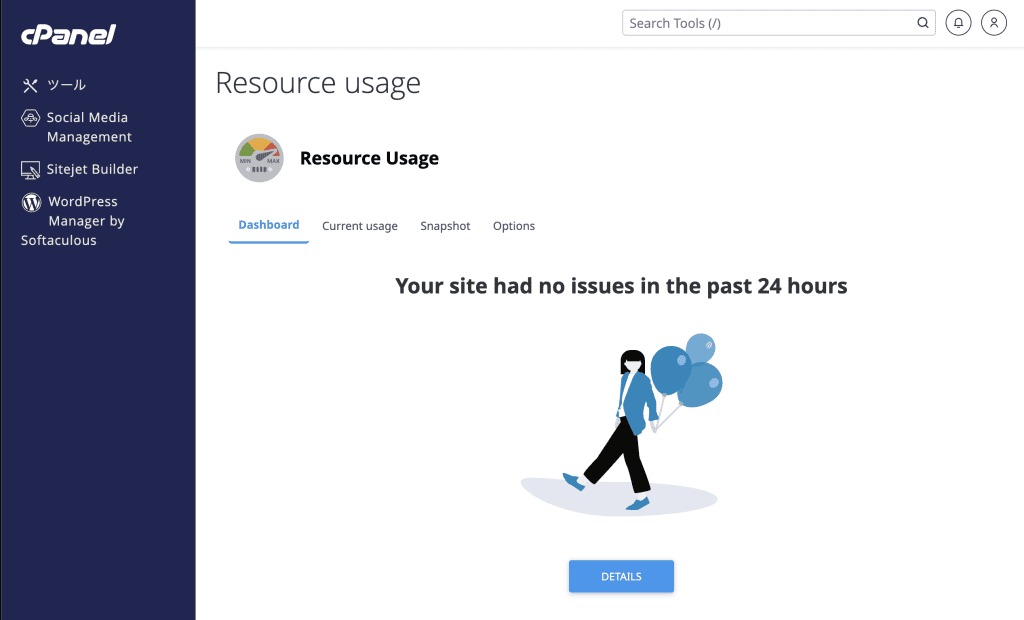
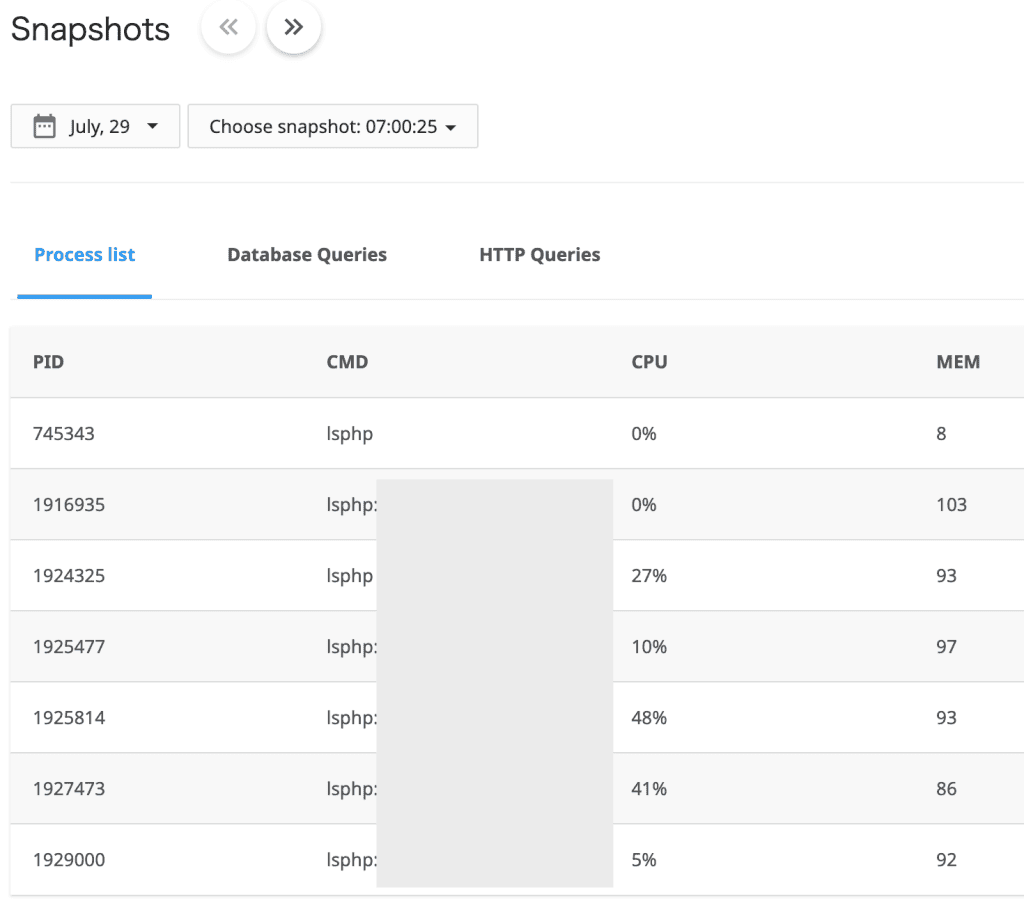
まずcPanelの「Resource Usage」を確認すると、過去24時間でCPU上限到達した表示があり、上限に到達した瞬間のプロセス一覧を自動記録してくれるスナップショットを見ていくと、明確な問題が2つ見つかりました。
oEmbedの自己参照ループバック
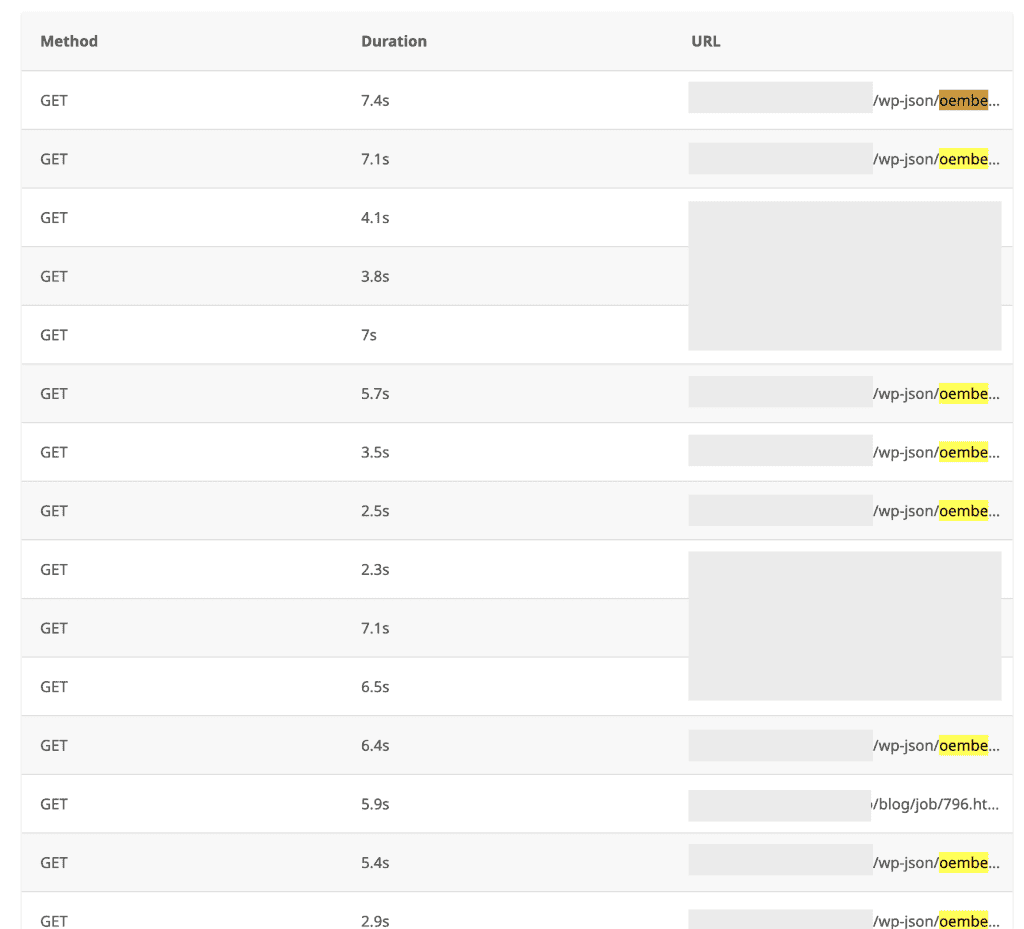
PHPプロセスが同時に18本以上起動していて、その多くが自サイト向けのREST APIへのHTTPセルフリクエストで、1件あたり2〜7秒かかっているのがわかります。ブログ記事同士の内部リンクをoEmbedとして自動変換しようとして、自サイトを自ら叩いてしまっていました。
存在しないファイルへのアクセス
そして次に、apple-touch-icon.pngという、iOS端末が自動的に取りに来るファイルが存在せず、そのたびにWordPress全体が一通り処理した後に404を返していました。1件あたり6〜17秒。地味ですが、塵も積もればで結構な負荷です。
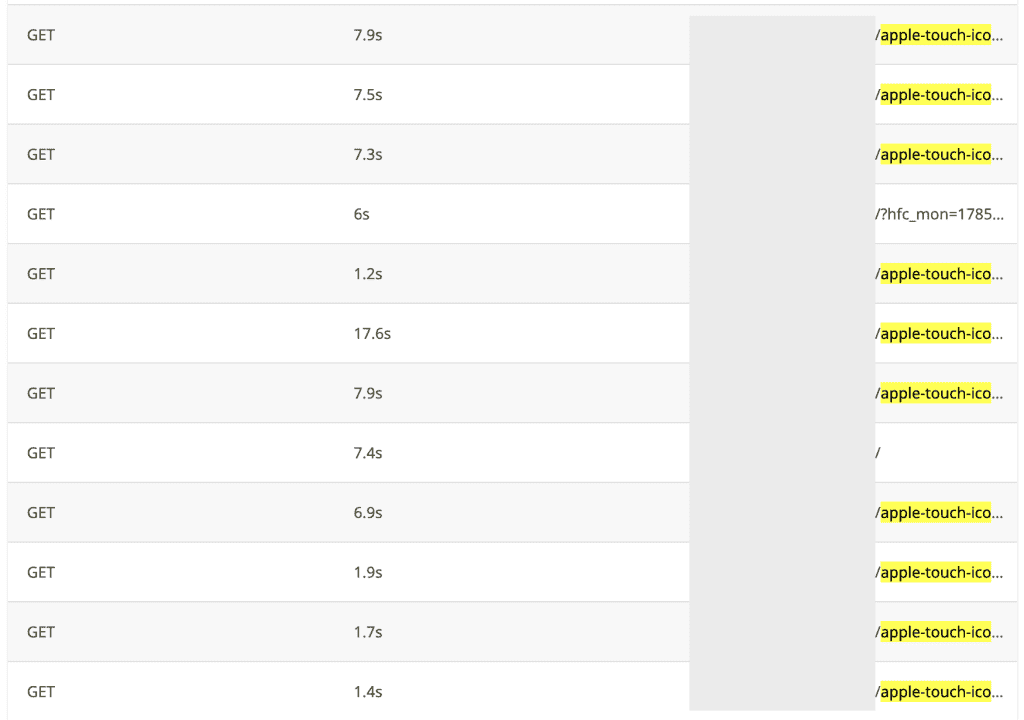
どちらもフィルタ追加と静的404化で修正しました。正直、これで直ったと思っていましたが、slack 通知アラートは収まらず。
調査2: 泥臭い切り分け作業で原因を絞っていく
軽い原因を片付けた後は、切り分け作業です。結果的に原因ではなかった調査も、原因候補を消していく作業として全部意味がありました。
Cloudflare, mixhost 周りは完全に候補外
サーバーが自分自身のドメインに接続するとタイムアウトする現象から、可能性としてCloudflare周りを疑いました。そこでCloudflareを完全に迂回してオリジンに直接アクセスしてみると、経由時と全く同じ確率で失敗。
さらに決定的だったのは、同一サーバー・同一リソース割当の上にある非公開のステージングである検証環境に同条件でアクセスすると、5回とも20ms前後で完全に安定していたことです。同じ環境で、本番サイトだけが遅い。つまりネットワークではなく、本番サイトのアプリケーション側の問題です。
キャッシュではない。しかしクエリ付きURLで大きな差
次にキャッシュファイルの実体を確認しました。ページキャッシュは WP Rocket の領域で、キャッシュ自体は正常に機能していました。ところが、素のURLとクエリ文字列付きURLを並べて計測すると差が歴然でした。
- クエリ文字列なし: 0.13秒前後で安定
- クエリ文字列あり: 1.6秒〜60秒と大きくばらつく
ページキャッシュはクエリ文字列付きのアクセスを毎回キャッシュ迂回させます。広告流入のUTMパラメータ、各種の計測用パラメータなど。クエリ文字列を伴うあらゆるアクセスが、毎回フルにPHPを実行していたのです。
監視システムがキャッシュ回避のために毎回ユニークなクエリ文字列を付けてアクセスする設計だったことで、この発見につながりました。
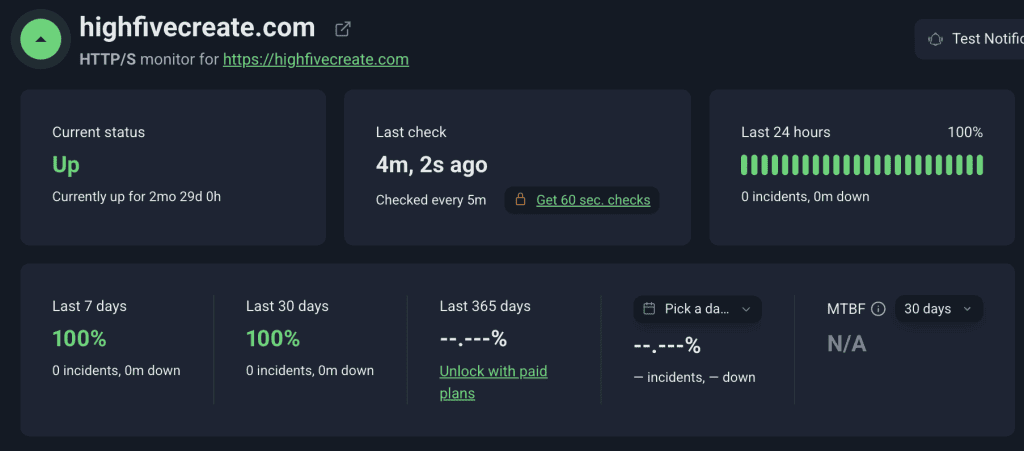
ちなみに、もう一つ監視サービスの Uptimerobot で並行して監視していますが、今回は500エラーなどでダウンしているわけではないため、全く通知せず通常モード。
OPcacheや重いプラグインではなかった
WordPress のサイトヘルスの指摘に従いOPcacheを有効化しましたが、これ単体では改善せず。
また、重いプラグインも関係無し。 重そうなプラグインを3つ無効化して計測しても、ばらつきは変わらず。特定の1つが重いのではなく、全体で積み上がる系の問題の可能性が濃厚だと仮定しました。
調査3: 決め手は「TTFBは速いのに、表示が終わらない」
cPanelのリソース使用状況を時間帯別に眺めると、はっきりしたパターンがあることに気づきます。深夜〜早朝は同時プロセス数2〜3で安定、日中は8〜13でCPU上限到達が頻発。そして問題の時間帯にライブで計測を繰り返して、決定的な観測にたどり着きます。
TTFB(最初の1バイトが届くまで)は常に0.4〜0.7秒と速い。なのに、応答が完了するまでの時間だけが1.7秒〜46.6秒と異常にばらつきがある。
これは「混んでいて順番待ちになっている」挙動ではなく、PHPプロセス自体はすぐ起動しているものの、実行の途中でアカウントのCPU割当を使い切り、処理速度そのものが制限されている、共有サーバーのスロットリングの挙動でした。


では、なぜ日中の同時アクセス程度でCPUを使い切るのか。ここでサイトヘルスのある指摘を思い出しました。
原因は永続オブジェクトキャッシュがなかったこと
「永続オブジェクトキャッシュを使用してください」。サイトヘルスに常に表示されていた推奨事項です。RedisやMemcachedが使える専用環境向けの話だと思い、後回しにしていました。
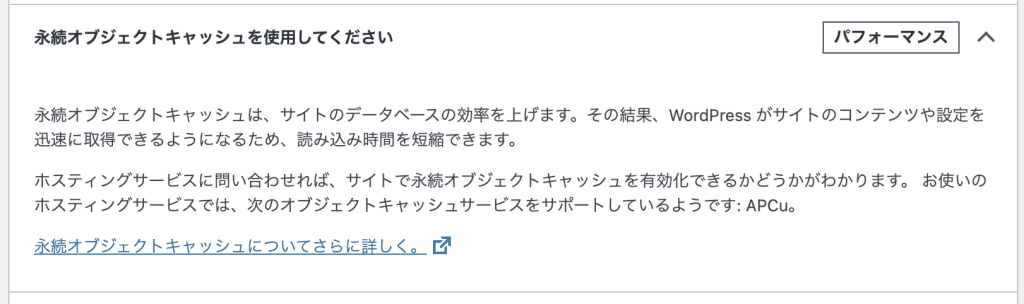
永続オブジェクトキャッシュがないWordPressは、リクエストのたびに設定値・一時データ(トランジェント)・各種メタデータをデータベースへ問い合わせます。「1つ1つのクエリは軽くても、同時アクセスが増えるほどCPU消費の合計が積み上がり、共有サーバーの割当てる上限になった途端、全リクエストがまとめて遅くなる。しかも日中だけ遅い、特定の重い処理が見つからない」という今回の症状にハマります。
共用サーバーでもオブジェクトキャッシュを有効化できる
やったことは、APCu拡張を有効化したことと、WordPress.org公式プラグインとして公開されている、オブジェクトキャッシュプラグインのSQLite Object Cacheを導入しました。このプラグインはRedis/Memcachedが使えない共有サーバー向けに設計されています。
まず検証環境でキャッシュが正しく機能すること・値が正しく返ること・エラーログに異常がないことを確認してから、本番に同一手順で展開しました。
結果、「20件/時間」が「38時間連続ゼロ」へ
導入後、1時間おきの自動検証ジョブで応答時間・リソース状況・遅延件数を記録し続けました。対策前と全く同じ時間帯での比較がこちらです。
| 対策前 | 対策後(同時間帯) | |
|---|---|---|
| 応答遅延+タイムアウト件数 | 約95件(毎時14〜20件) | 0件 |
「深夜は元々空いているから当然では?」という反論に対し先に書いておくと、対策前は深夜帯にも1時間ごとに14〜20件の遅延が出ていました。その同じ深夜帯で95件→0件。問題が集中していた日中ピーク帯も、38時間以上を通して完全にゼロ。cPanelの「Resource Usage」ダッシュボード表示も「過去24時間で問題なし」に切り替わりました。

監視が捉えるより前にすでに遅延は発生していた
cPanelのスナップショットをみて気が付きました。スナップショットは上限到達したタイミングで記録されるのですが、記録を何日かさかのぼって見てみると、Slack通知が始まる前の分も残っていました。つまり、監視が遅延として捉えるより前から、CPU上限への到達そのものは既に発生していたことになります。すでに表面化する前から症状は出ていたのです。
極端に遅いケースでのLCPで31.8秒→7.8秒に大幅改善
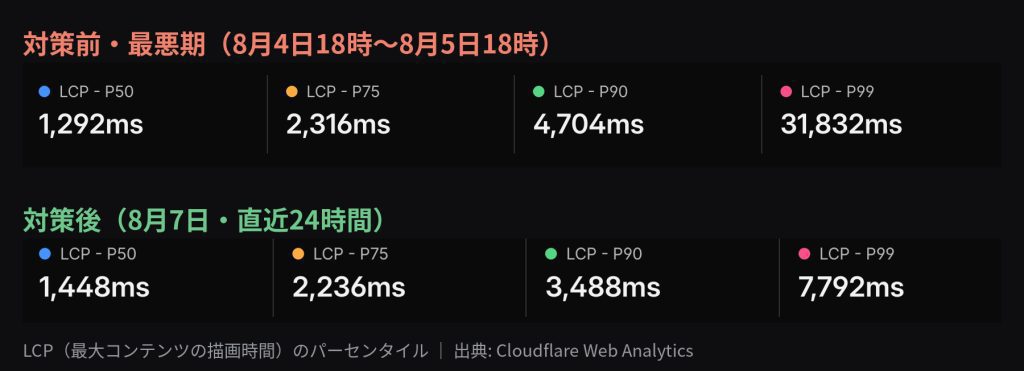
サーバー側の数字だけではなく、実際の訪問者側の計測としてCloudflareのWebアナリティクスにも、同じ構造がはっきり残っていました。対策実施の直前24時間である最も遅延障害がひどかった時期のLCP(最大コンテンツの描画時間)は、P99(遅い方から1%の最も悪い値)が31.8秒。対策後は7.8秒と、約4分の1に改善しました。
一方でP50(中央値)は、最悪期1.29秒・対策後1.45秒。むしろ対策前の方がわずかに速いくらいで、これは誤差の範囲で大きな変化がないことを示しています。
この「中央値は動かず、最も悪い値だけが改善」という形が今回の障害の構造です。キャッシュされたページはもともと速かった。遅かったのは、キャッシュを迂回してPHPをフル実行していた一部のリクエストだけ。だから平均や中央値を見ていても異変は小さく、P99に問題が溜まっていたわけです。表示速度を「平均◯秒」だけで見ていると、この種の障害は見逃しますね。
念のため補足ですが、この前後の期間で訪問数は1日あたりほぼ同水準でした。「アクセスが減ったから速くなった」わけではありません。
「永続オブジェクトキャッシュ」の指摘を放置していたら要注意
共有サーバーでWordPressを運用していて、「日中だけ遅い」「たまに異常に遅い」「でも特定の重いページがあるわけではない」という症状に心当たりがあるなら、サイトヘルスに「永続オブジェクトキャッシュ」の指摘があるかどうか確認してみましょう。
- サイトヘルスに「永続オブジェクトキャッシュを使用してください」と表示されていないか
- CPUの上限が記録されていないか
- 表示の遅さが「時間帯依存」ではないか(深夜は速いのに昼は遅いなど)
- 計測するときはキャッシュに載ったページだけでなく、クエリ文字列付きのURLでも測っているか
そしても今回の対応で最も得た価値は、症状を発覚できた仕組みが正しく動作した事実と、原因把握までに様々な対策を行った経験。oEmbedループバック、存在しないファイルへの404といったスナップショットからわかる可能性の高そうなことを修正しても直らず、ネットワーク・キャッシュ・PHP設定・プラグインと1つずつ消して、時間帯パターンとTTFBの内訳からようやくたどり着きました。監視の仕組みがなければ発覚も遅れ、検証環境がなければ切り分けることもできませんでした。
WordPressの保守を行っている会社の自社サイトが遅くなった話を公開するのは正直少し恥ずかしいのですが、保守の価値は「問題が起きないこと」ではなく、起きたときに気づけること、原因を洗い出して一つずつ実施し切れること、直ったことをデータで証明できることだと考えています。今回それが自社サイトで検証できたことは一定の価値があります。
ご自身のWordPressで同じような症状に心当たりがある方、サイトヘルスの警告を放置したままの方は、WordPress保守管理サポートからお気軽にご相談ください。監視の仕組みづくりから原因調査まで実行します。


コメントを残す